
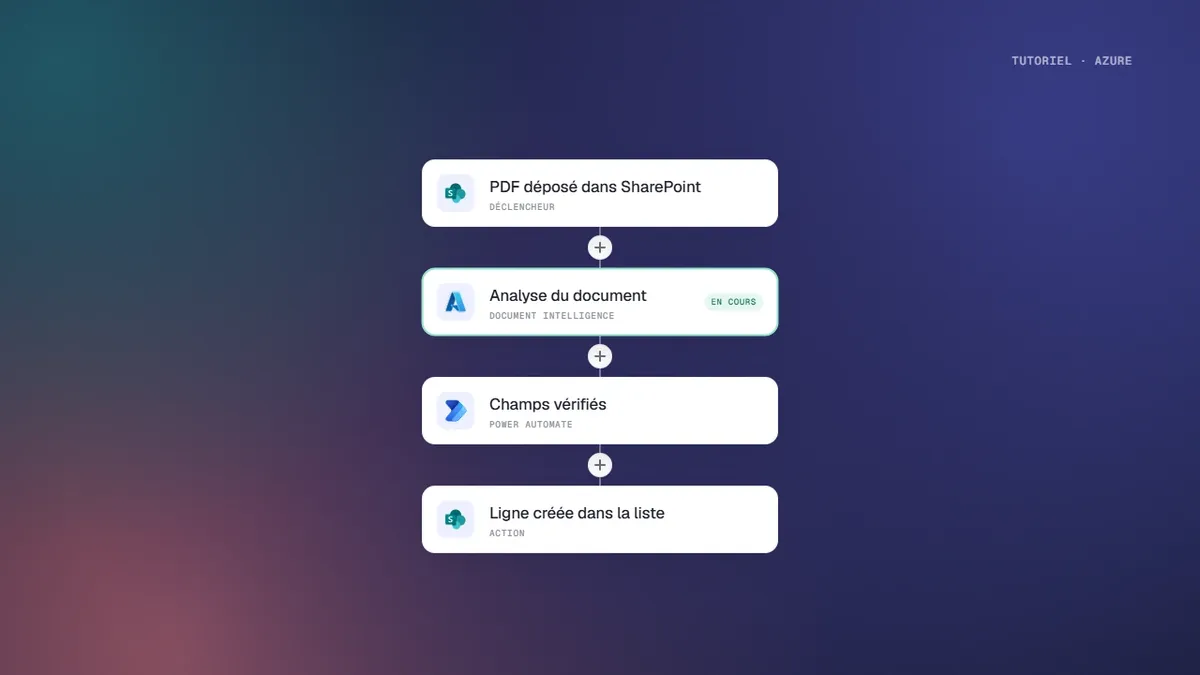
Recopier à la main les données d’un PDF ou d’un Word prend du temps et crée des erreurs. Azure Document Intelligence, le service de lecture de documents de Microsoft, associé à Power Automate, automatise cette saisie.
En bref
Azure Document Intelligence (anciennement Form Recognizer) lit un document et en extrait le texte, les tableaux et des champs précis : montant d’une facture, numéro de commande, date. Un flux Power Automate lui envoie chaque nouveau PDF déposé dans SharePoint ou OneDrive, récupère les champs extraits et crée l’élément correspondant dans une liste. Le service se paie à la page, avec un niveau gratuit pour tester.
Les modèles disponibles
| Modèle | Ce qu’il extrait | Usage |
|---|---|---|
| Lecture | Le texte imprimé ou manuscrit, ligne par ligne | Rendre cherchable un document numérisé |
| Mise en page | Le texte, les tableaux, les titres et les cases à cocher | Reprendre les tableaux d’un rapport PDF |
| Modèles prédéfinis | Les champs des factures, reçus, pièces d’identité, contrats | Saisie des factures fournisseurs |
| Extraction personnalisée | Les champs de vos propres documents, après entraînement | Bons d’intervention, formulaires internes |
| Classification personnalisée | Le type de chaque document reçu | Trier un lot de documents avant l’extraction |
Ce qu’il faut avant de commencer
Ce guide montre, étape par étape, comment extraire les données d’un PDF et les ranger dans une liste SharePoint. Il faut :
- un abonnement Azure avec une ressource Document Intelligence ;
- une licence Power Automate Premium, pour les actions HTTP ;
- un site SharePoint avec une ou plusieurs listes cibles ;
- des fichiers PDF stockés dans SharePoint ou OneDrive.
Étape 1 : Configurer une ressource Azure Document Intelligence
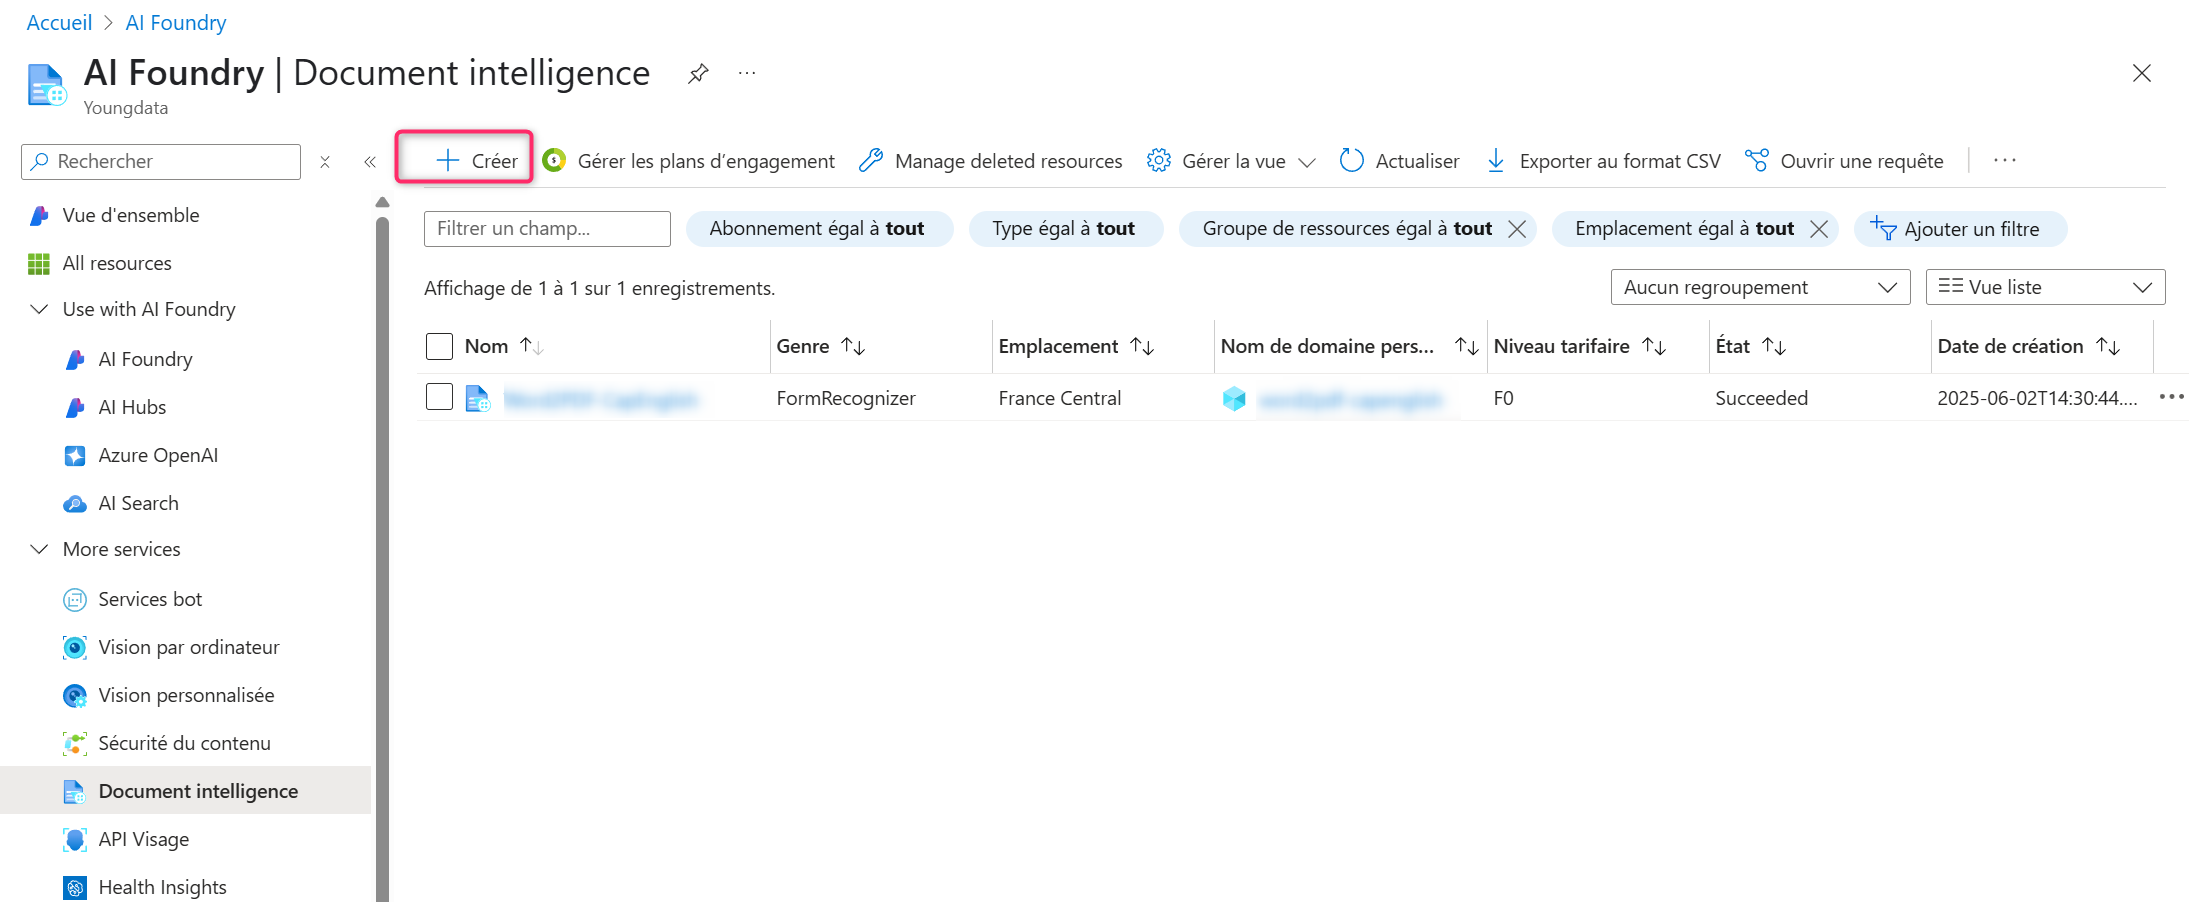
Créez une ressource Document Intelligence dans le portail Azure pour traiter vos PDF.
1. Connectez-vous au Portail Azure.
2. Créez une nouvelle ressource Document Intelligence.
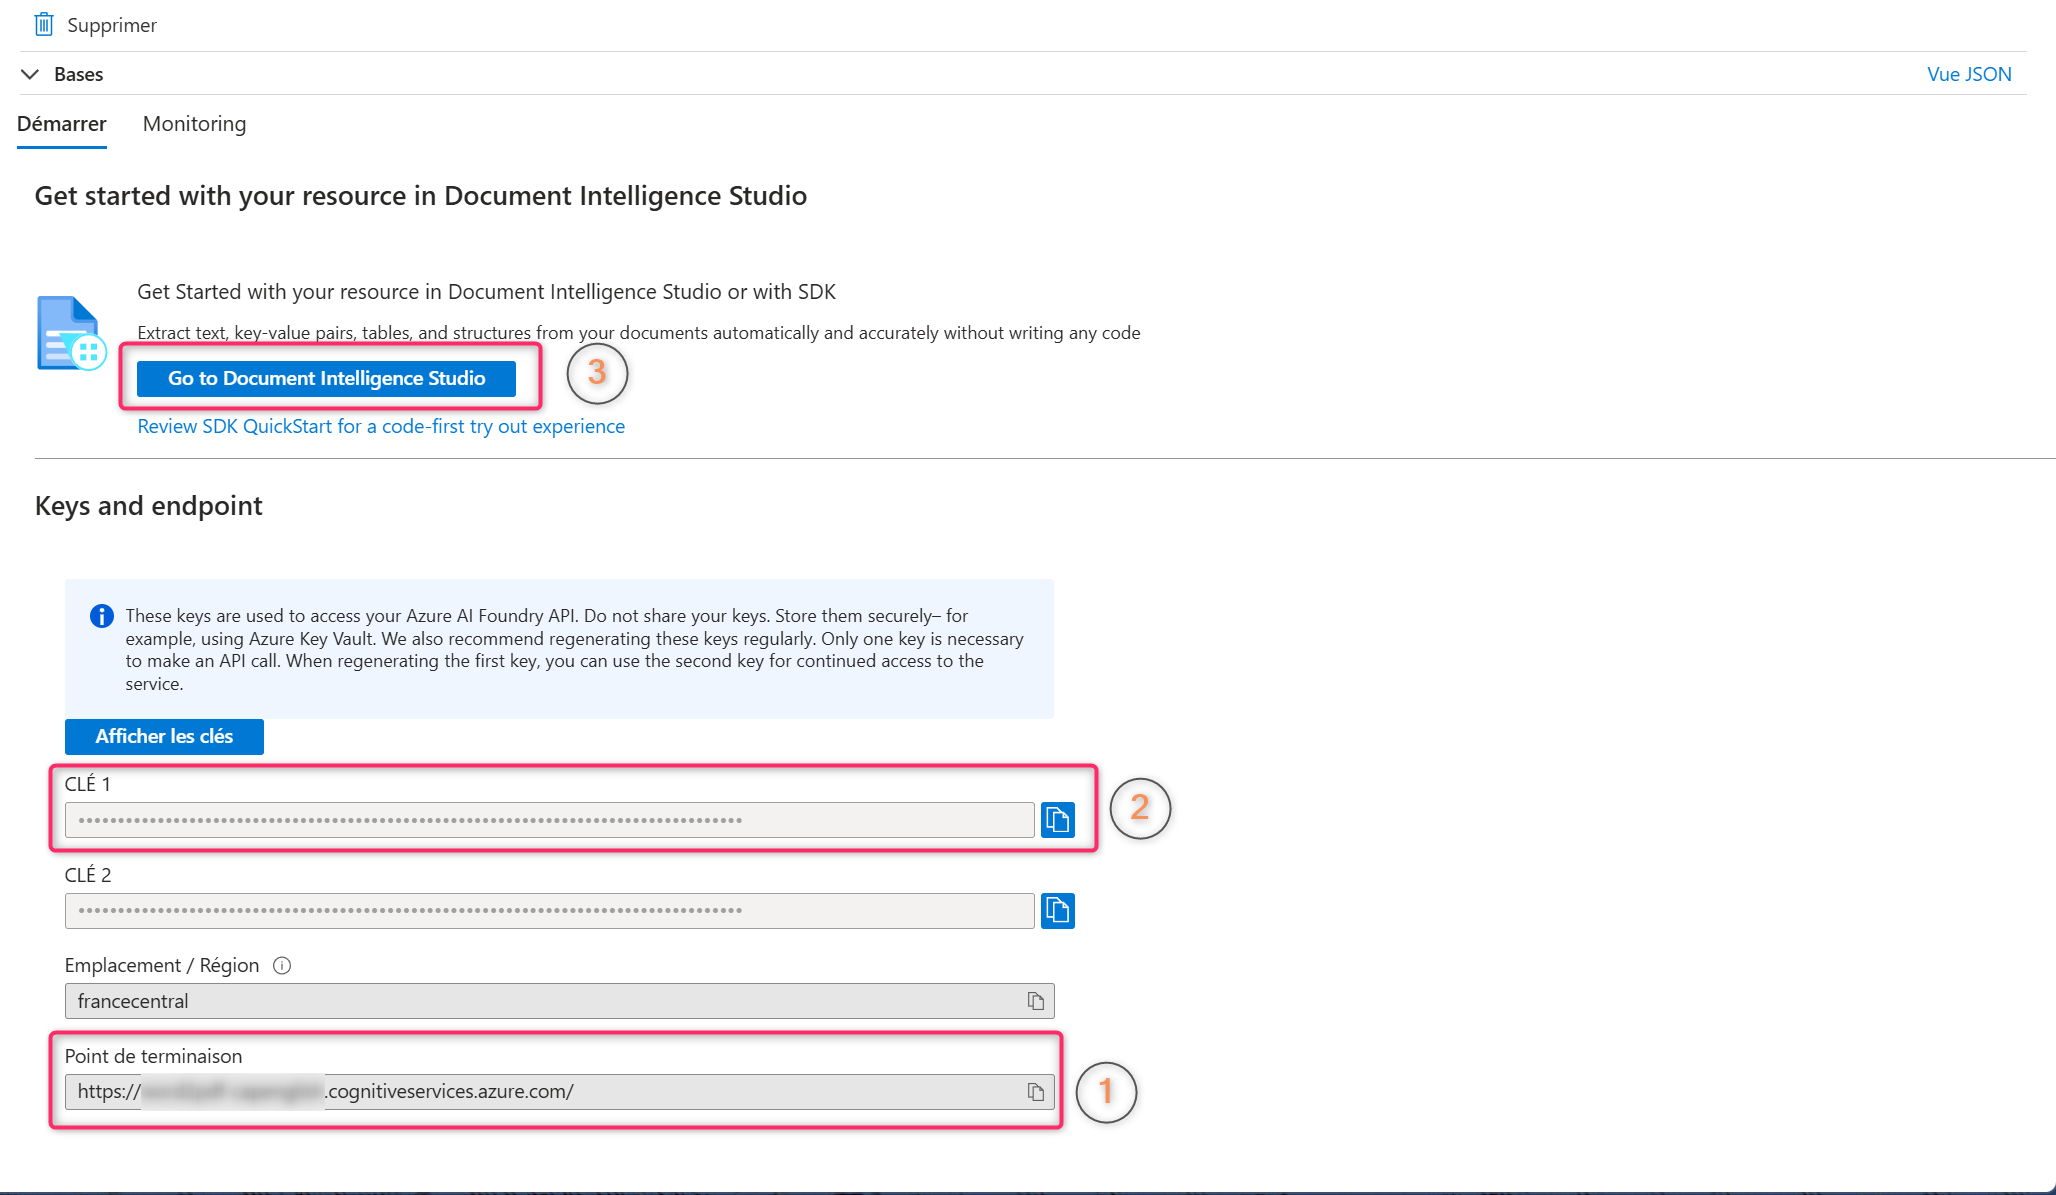
Notez le point de terminaison ( https://<votre-ressource>.cognitiveservices.azure.com/) et la clé 1 API dans la section "Clés et point de terminaison", puis accéder au Studio Document Intelligence.
Choisir un modèle prédéfini ou créer votre propre modèle personnalisé, c’est notre cas car nos documents ne sont pas des documents universels comme les factures.
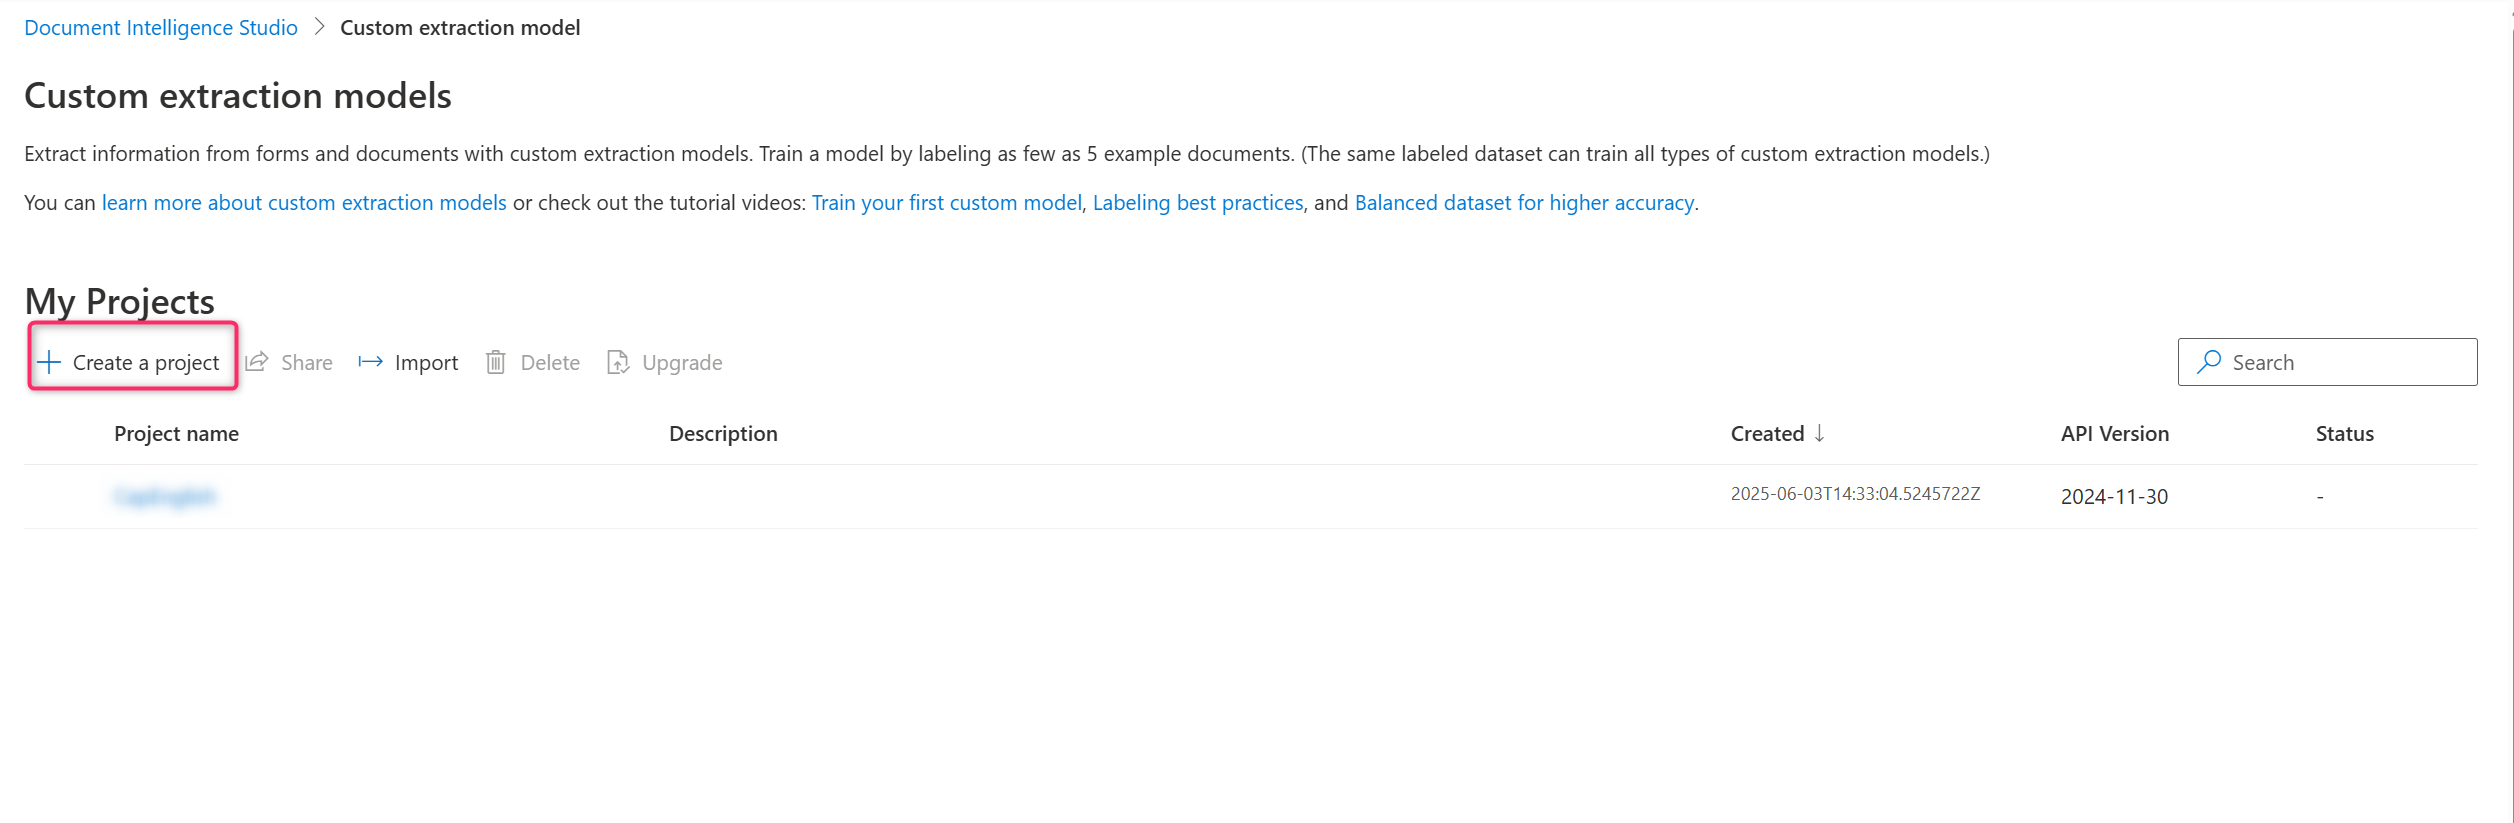
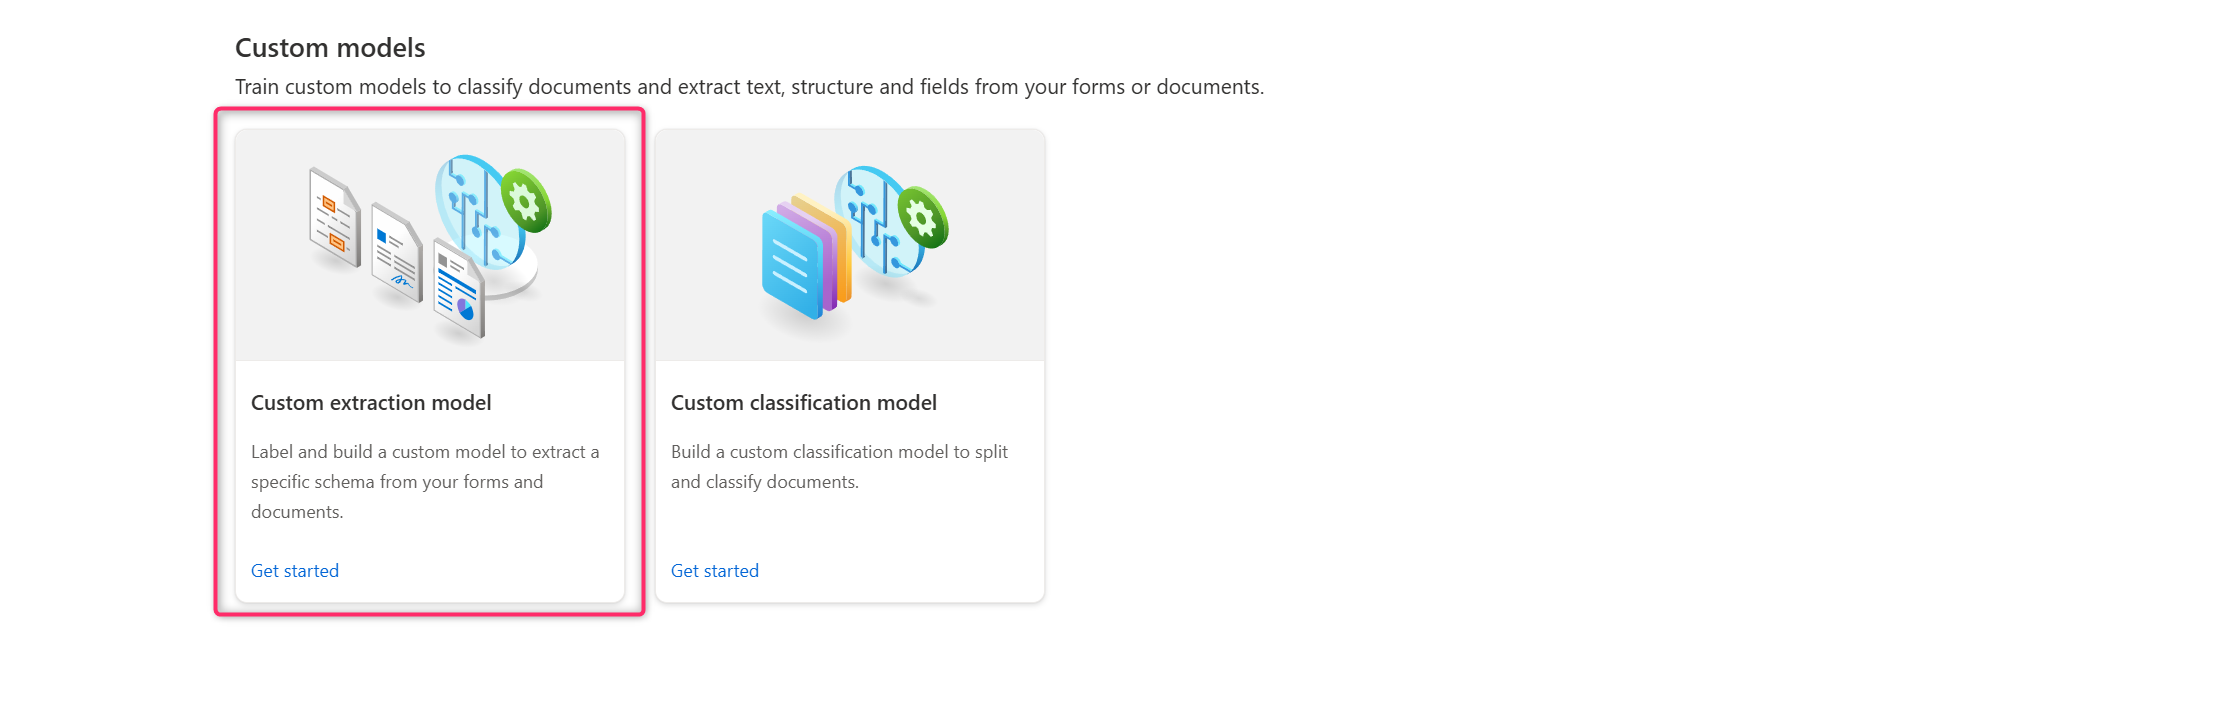
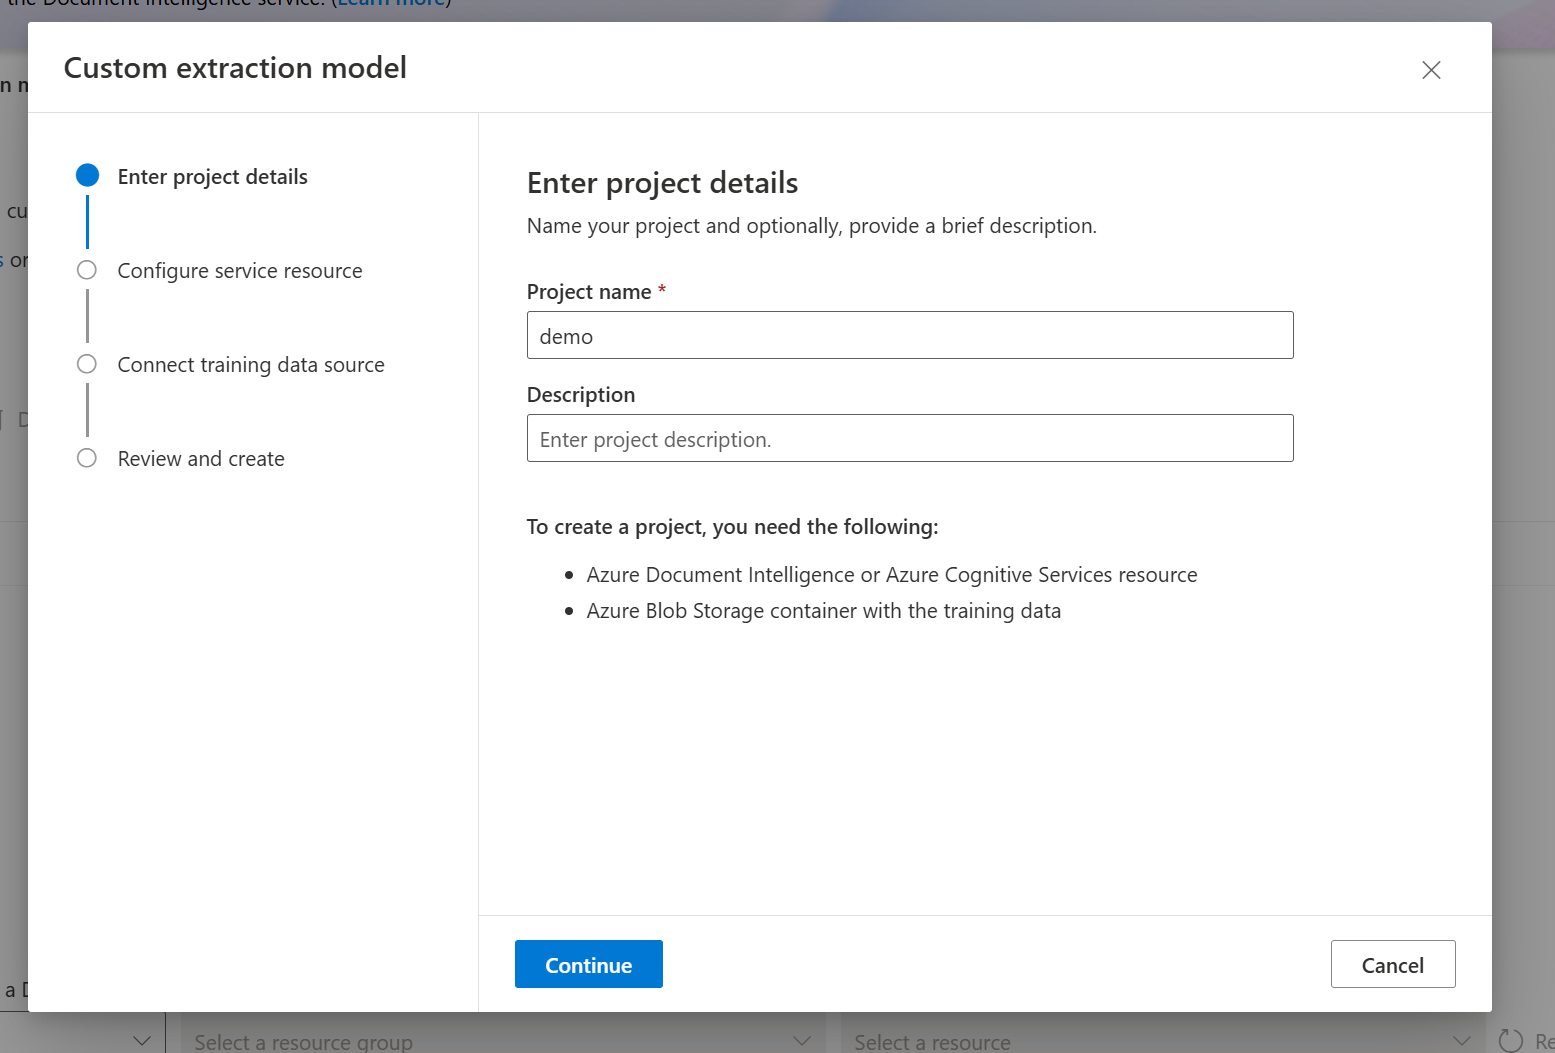
Créer un nouveau modèle personnalisé.
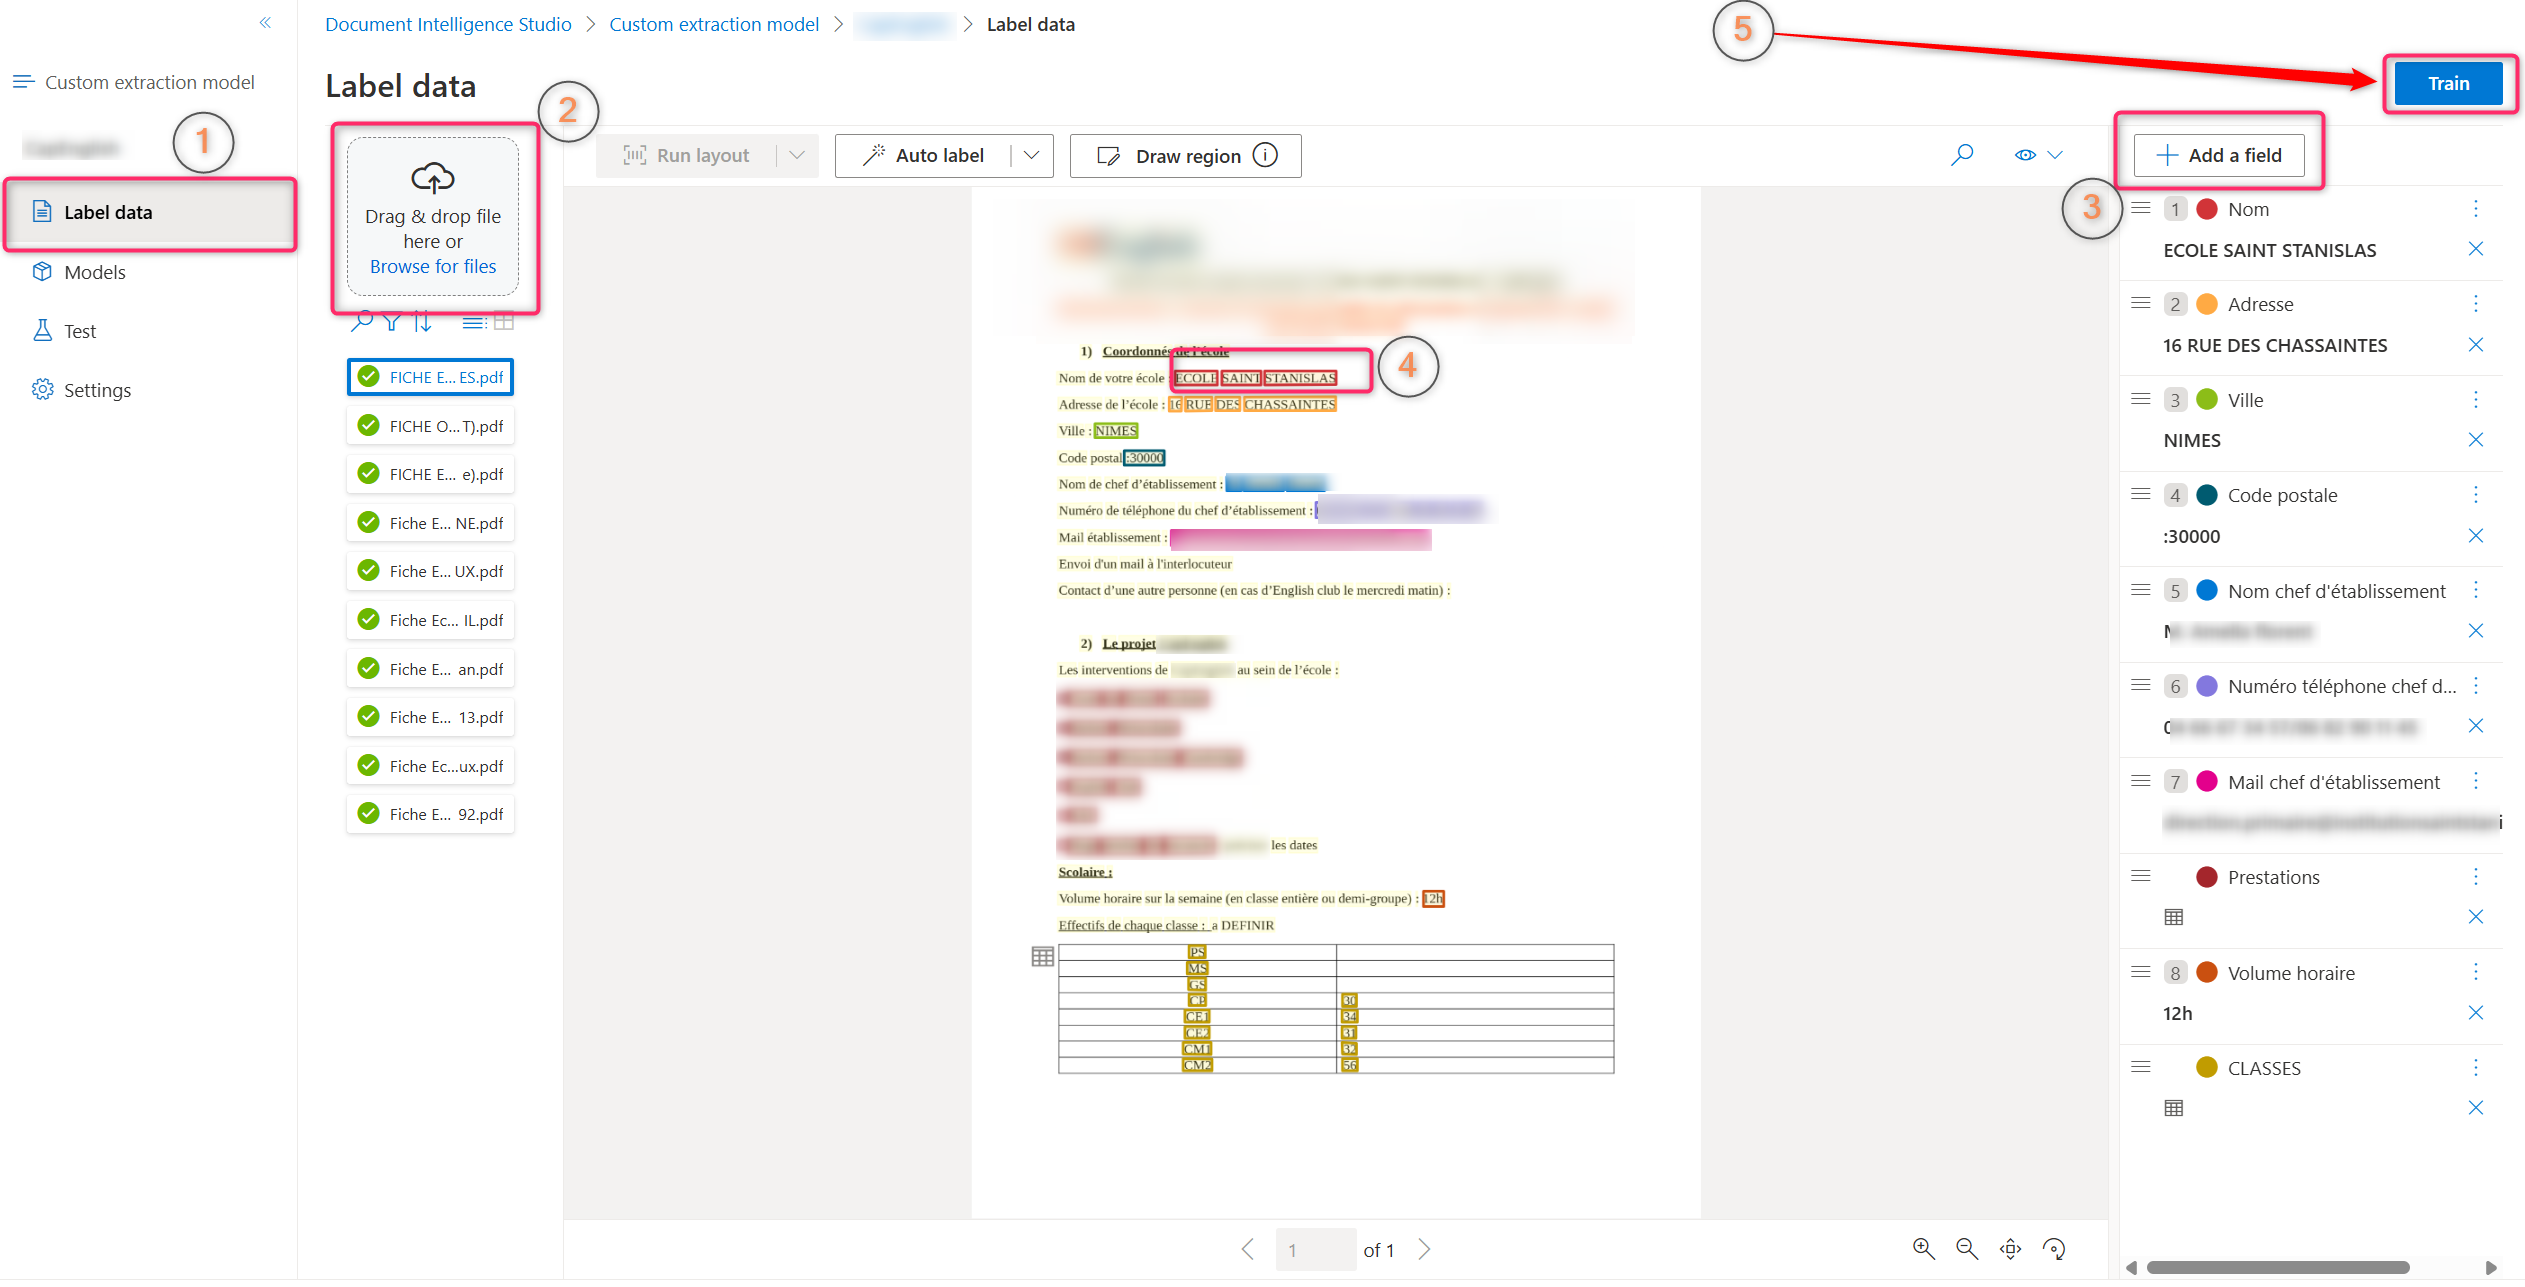
Entraînez un modèle personnalisé dans Document Intelligence Studio pour reconnaître les champs de vos PDF (par exemple, texte, tableaux, cases à cocher).
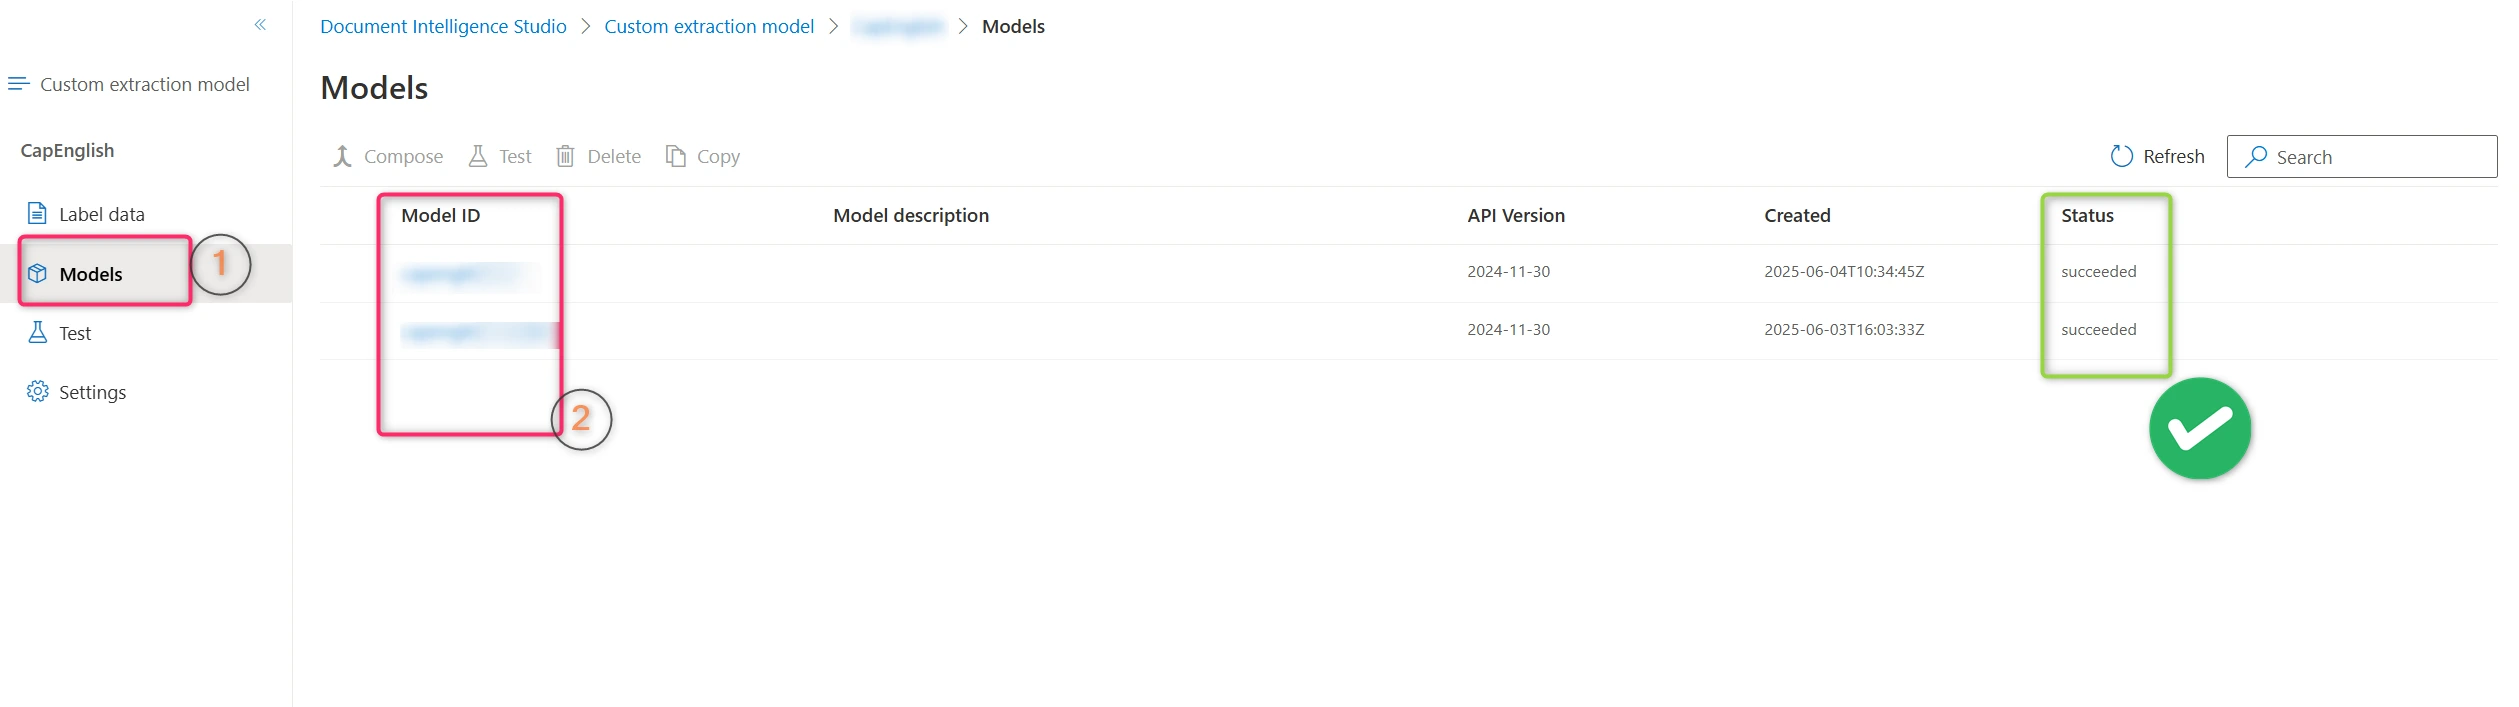
Le statut du modèle personnalisé doit être réussi.
Étape 2 : créer le flux Power Automate
1. Accédez à Power Automate et créez un nouveau flux cloud automatisé.
2. Choisissez le déclencheur "Lorsqu’un fichier est créé (OneDrive for Business)" ou "Lorsqu’un fichier est créé dans un dossier (SharePoint)".
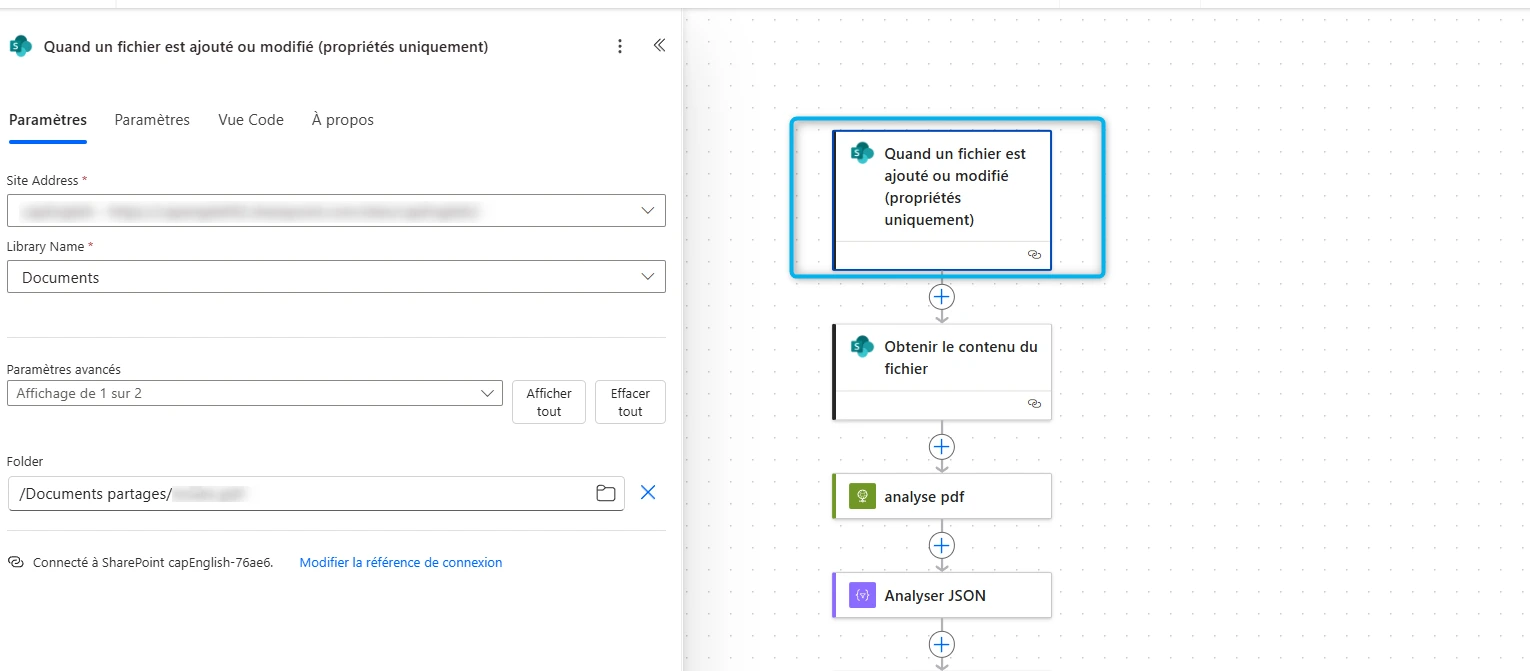
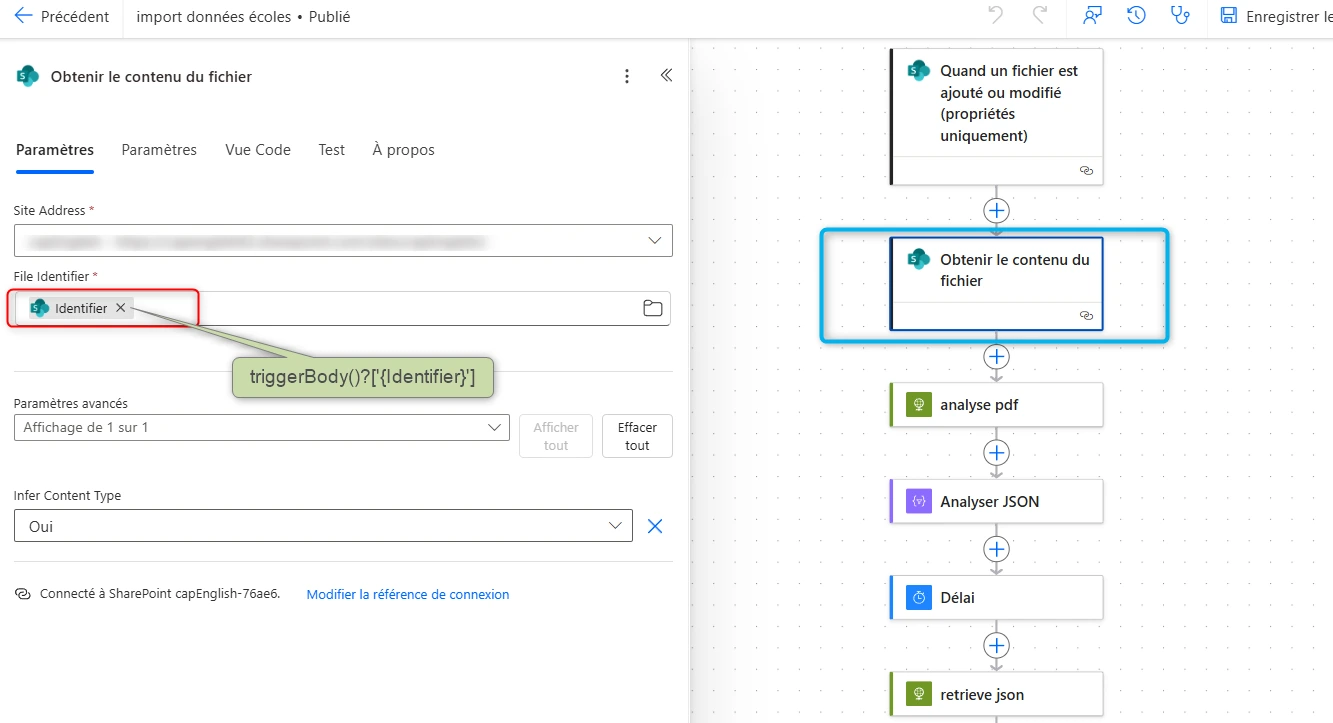
3. Ajoutez l’action "Obtenir le contenu du fichier" (connecteur OneDrive/SharePoint).
4. Sélectionnez l’identifiant du fichier à partir du contenu dynamique du déclencheur (ex. : "Identifiant du fichier").
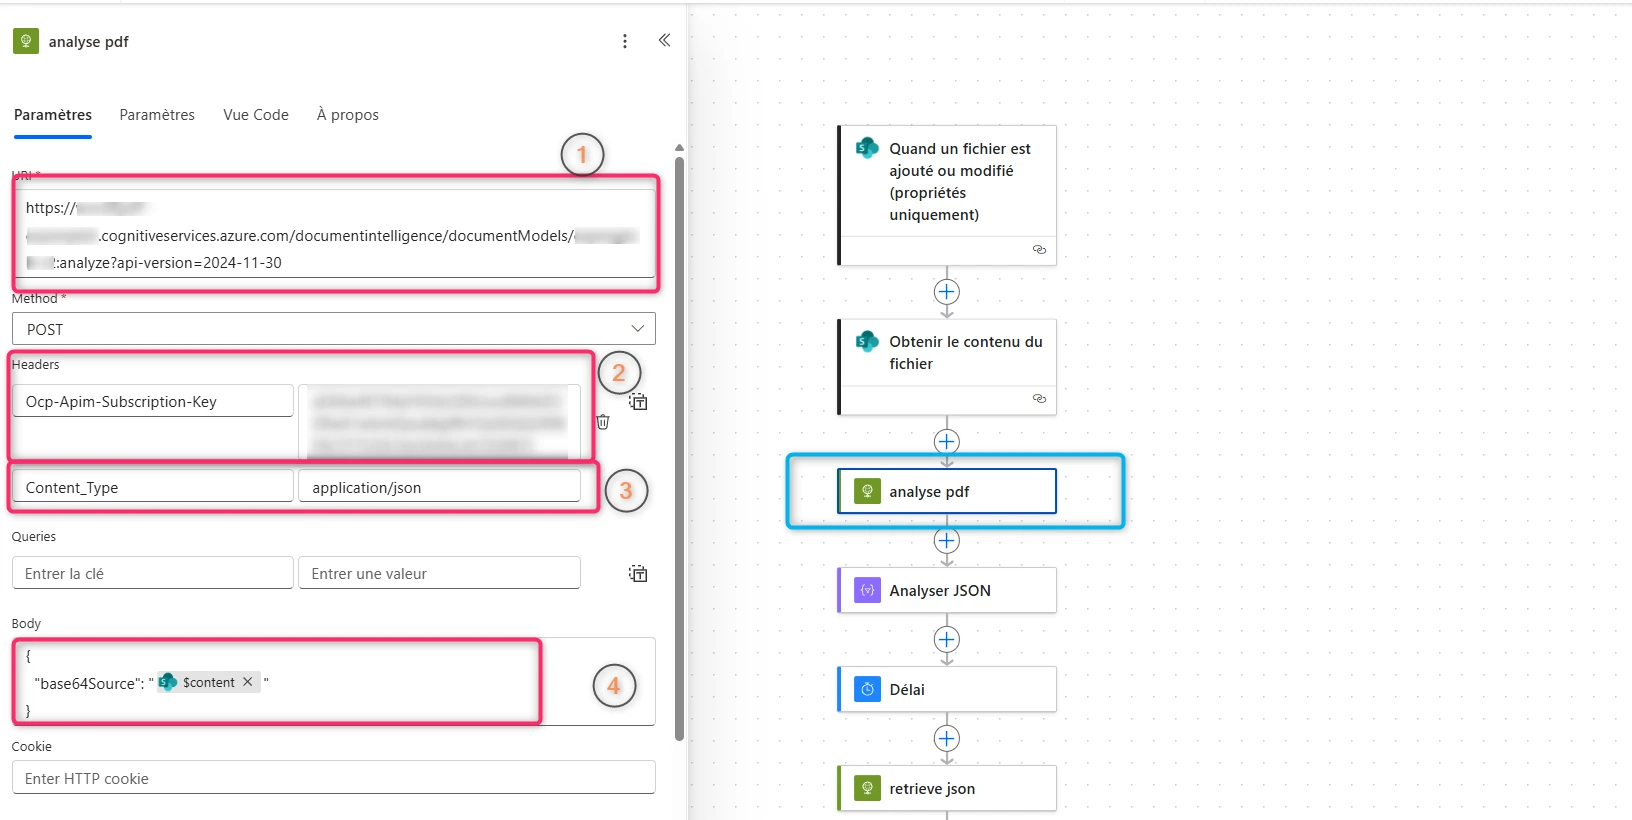
5. Ajoutez une action "HTTP" (connecteur Premium).
6. Configurez :
Méthode : POST
URL :

- En-têtes :
Ocp-Apim-Subscription-Key: <votre-clé-api>
Content-Type: application/json
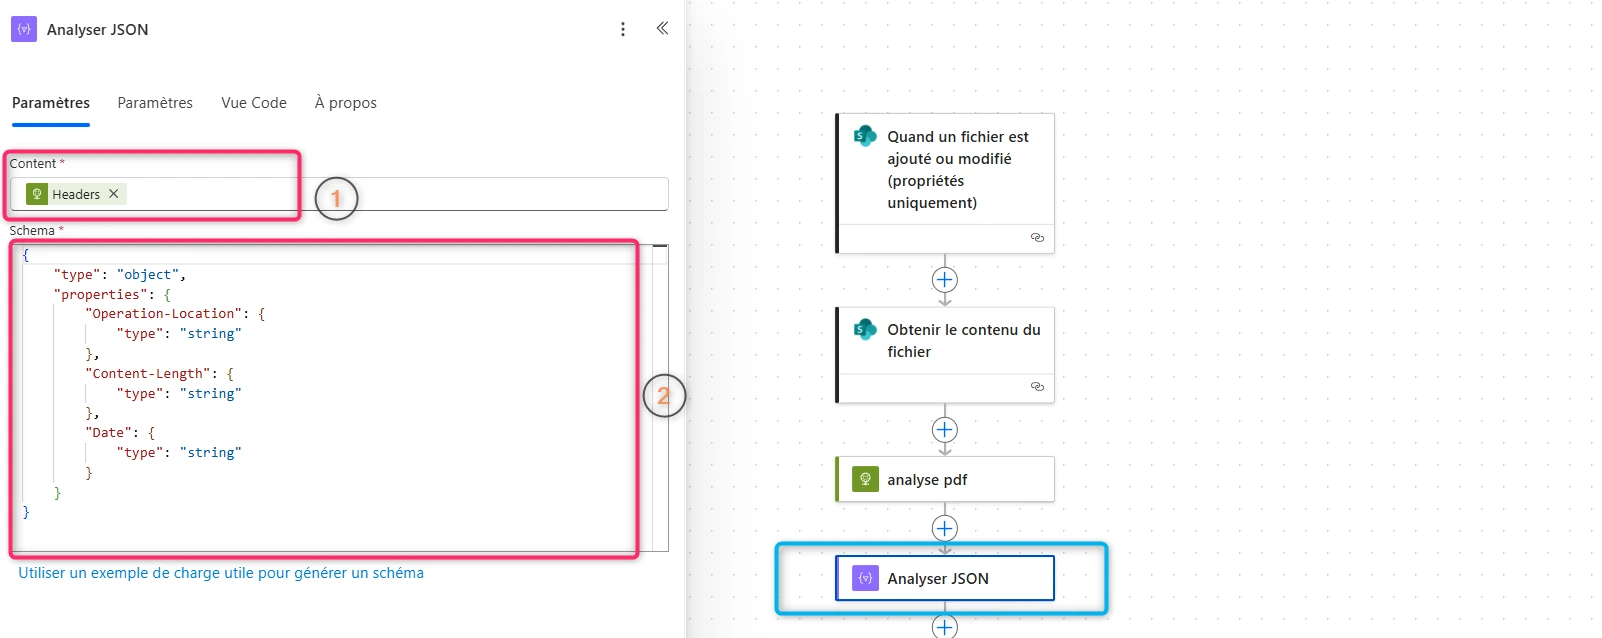
7. Analysez l’en-tête "Operation-Location" de la réponse pour interroger les résultats.
8. Ajoutez une action "Délai" (de 5 à 10 secondes, par exemple) pour attendre la fin du traitement.
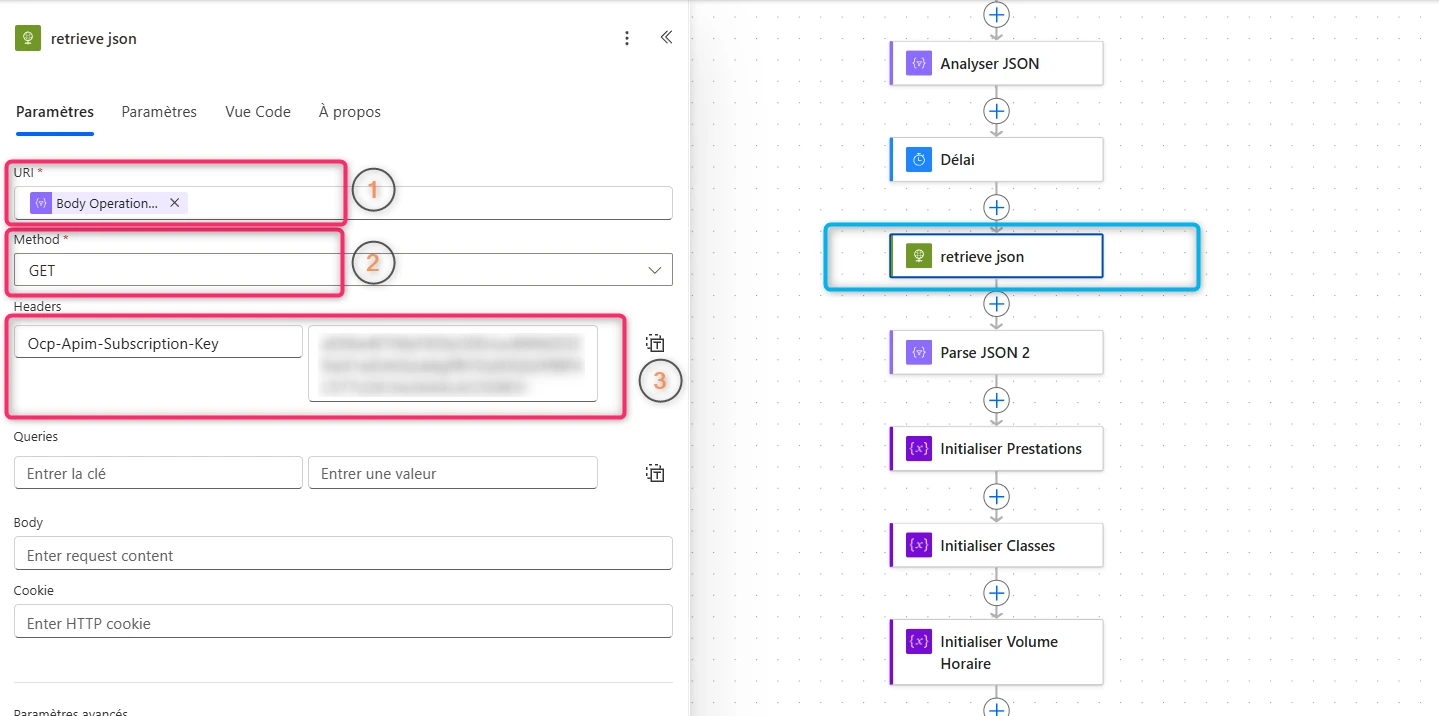
9. Ajoutez une action "HTTP" :
- Méthode : GET
- URI : Contenu dynamique de l’en-tête "Operation-Location" de l’action HTTP précédente.
- En-têtes :
Ocp-Apim-Subscription-Key: <votre-clé-api>
10. Ajoutez une action "Analyser JSON".
11. Définissez le contenu sur le corps de la deuxième action HTTP.
12. Fournissez un schéma JSON basé sur la structure de la réponse de Document Intelligence (ex. : champs, tableaux). Utilisez une réponse d’exemple pour générer le schéma.
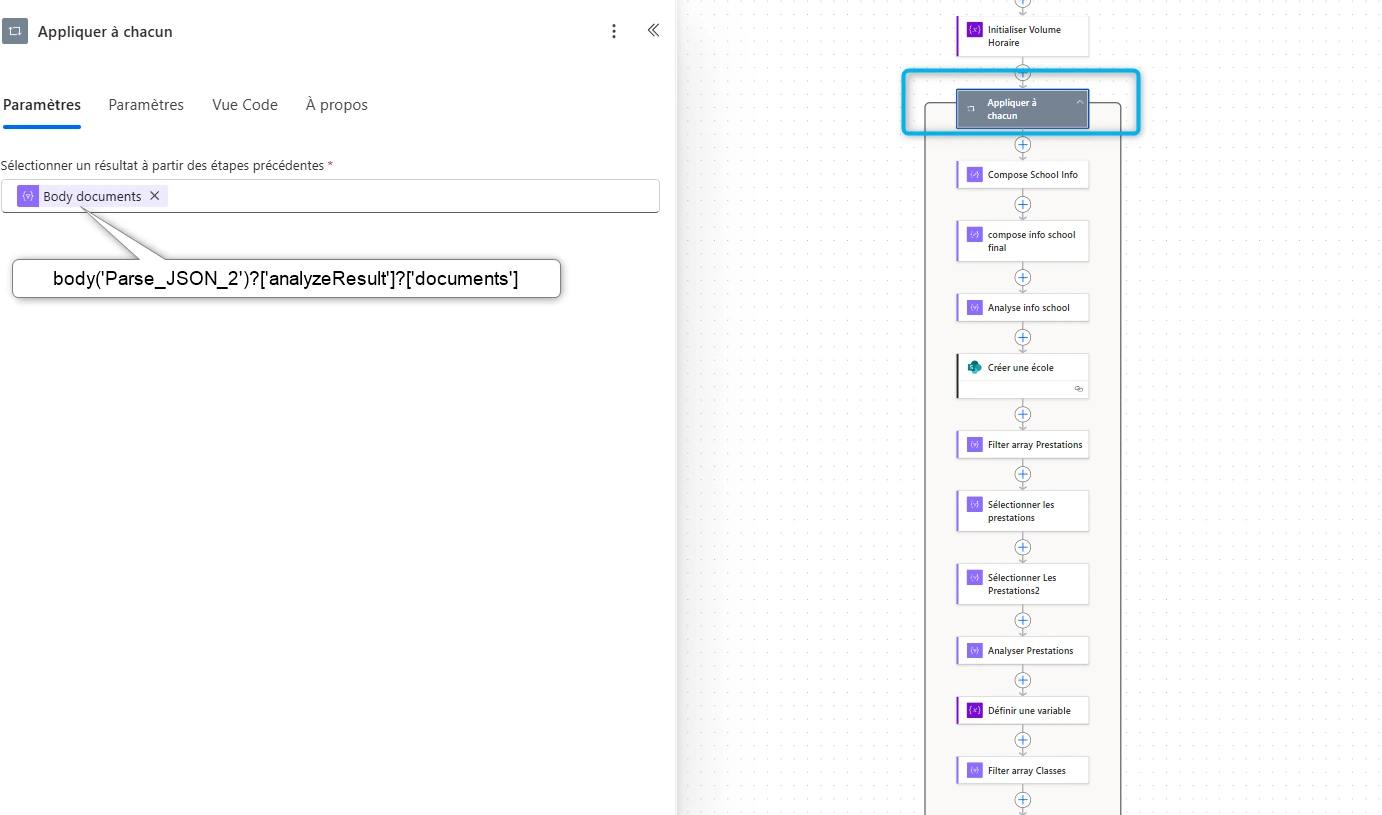
13. Ajoutez une action "Appliquer à chacun" pour itérer sur les documents : body('Parse_JSON_2')?['analyzeResult']?['documents'].
14. À l’intérieur, ajoutez des actions "Composer" pour créer des objets JSON correspondant aux champs de la liste (ex. : champs texte, nombres).
15. Utilisez "Filtrer le tableau" pour traiter les données tabulaires (ex. : inclure uniquement les lignes avec des valeurs spécifiques).
16. Ajoutez "Sélectionner" pour reformater les tableaux en objets JSON adaptés aux colonnes SharePoint.
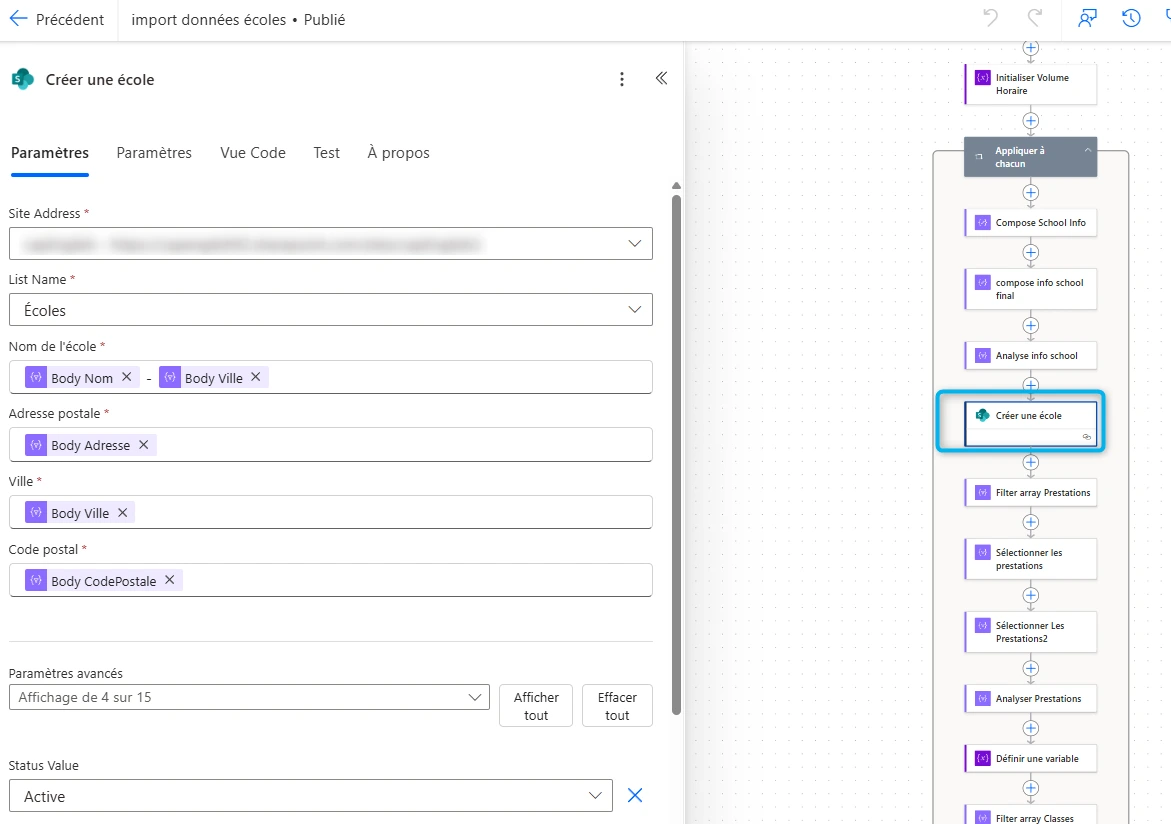
17. Ajoutez une action "Créer un élément".
18. Définissez l’adresse du site SharePoint et le nom de la liste.
19. Mappez les colonnes de la liste avec le contenu dynamique des actions "Composer" ou "Sélectionner".
20. Pour les relations (ex. : colonnes de recherche), utilisez les ID des éléments parents créés précédemment.
Étape 3 : contrôler la confiance des champs extraits
Chaque champ extrait arrive avec un score de confiance, entre 0 et 1. Dans le flux, une condition sur ce score envoie les documents douteux, par exemple sous 0,8, vers une liste « à vérifier » au lieu de créer l’élément directement : une personne contrôle ceux-là, les autres passent sans intervention.
Microsoft propose aussi un connecteur Azure AI Document Intelligence dans Power Automate, qui remplace les appels HTTP de l’étape 2 par une action prête à l’emploi.
Prix d’Azure Document Intelligence
| Modèle | Prix pour 1 000 pages |
|---|---|
| Lecture | 1,32 € (0,53 € au-delà d’un million de pages) |
| Mise en page et modèles prédéfinis | 8,80 € |
| Extraction personnalisée | 26,40 € |
| Classification personnalisée | 2,64 € |
Prix hors taxes à l’usage, relevés le 2 octobre 2026 pour la région France Centre. Mille factures d’une page reviennent donc à moins de 9 €. Le niveau gratuit traite 500 pages par mois, mais seulement les deux premières pages de chaque document : de quoi tester. Pour les gros volumes, des forfaits mensuels baissent le prix de la page.
AI Builder ou Document Intelligence : que choisir ?
| AI Builder | Azure Document Intelligence | |
|---|---|---|
| Où il se trouve | Dans la Power Platform | Dans un abonnement Azure |
| Mise en place | Action prête à l’emploi dans Power Automate et Power Apps | Ressource Azure, puis connecteur ou appels HTTP |
| Prix d’une page de facture | 8 crédits Copilot, environ 0,07 € | Environ 0,009 € |
| Modèle personnalisé | Entraîné dans Power Apps | Entraîné dans le studio Document Intelligence, avec plus de réglages |
| Pour qui | Volumes modestes, équipe Power Platform | Gros volumes, documents complexes, équipe à l’aise avec Azure |
Le fonctionnement d’AI Builder et son prix sont détaillés dans notre article sur AI Builder.
Limites et bonnes pratiques
- Sécurité : Vous pouvez utiliser Azure Key Vault pour stocker les clés API pour une meilleure sécurité.
- Gestion des erreurs : Consultez les journaux d’exécution pour diagnostiquer les problèmes, vous pouvez même ajouter des listes SharePoint de logs ou envoi de mail en cas d’erreurs.
- Performance : Ajustez le délai de polling pour les PDF volumineux.
- Précision extraction : Réentraînez votre modèle Document Intelligence si l’extraction des données est inexacte et analysez le score de chaque donnée.
Limites : une écriture manuscrite peu lisible, un tableau qui s’étend sur plusieurs pages ou un scan de mauvaise qualité font baisser la confiance, d’où le contrôle de l’étape 3. Pour les données, choisissez une région Azure européenne, par exemple France Centre.
Conclusion
En combinant Azure Document Intelligence et Power Automate, vous pouvez automatiser l’extraction de données à partir de PDF non structurés et leur intégration dans une liste SharePoint, cette méthode vous aide à réduire les tâches manuelles.
Ce flux est flexible et peut être adapté à différents formats de PDF et structures de listes.
À lire aussi :
- Les agents IA dans la Power Platform
- Le comparatif des IA en 2026 : classement et prix
- Power Automate, c’est quoi : définition, usages et prix
Questions fréquentes
Comment extraire automatiquement les données d’un PDF ?
Avec un flux Power Automate qui envoie chaque nouveau PDF à un service de lecture de documents, Azure Document Intelligence ou AI Builder, puis range les champs extraits dans SharePoint, Dataverse ou Excel. Les modèles prédéfinis lisent les factures et les reçus ; pour vos propres documents, on entraîne un modèle sur quelques exemples.
Combien coûte Azure Document Intelligence ?
Il se paie à la page : 1,32 € HT les 1 000 pages pour la lecture du texte, 8,80 € pour les modèles prédéfinis comme la facture, 26,40 € pour un modèle personnalisé (prix relevés le 2 octobre 2026). Le niveau gratuit traite 500 pages par mois.
Azure Document Intelligence sait-il lire les factures ?
Oui, avec le modèle prédéfini de facture, qui extrait sans entraînement le fournisseur, le client, les dates, les montants, les taxes et les lignes de détail. Les factures très atypiques gagnent à passer par un modèle personnalisé.